Infraestructura de IA

Implementación de IA Autoalojada

Puesta en marcha de modelos ajustados a un propósito específico sobre infraestructura propia, para que las funcionalidades de IA operen como parte de la arquitectura del producto en lugar de depender de créditos medidos de terceros.

Qué cambia realmente el autoalojamiento

Qué cambia realmente el autoalojamiento

El autoalojamiento no elimina el costo de infraestructura: convierte una factura de terceros medida por token en cómputo, almacenamiento y responsabilidad operativa propios. Esa contrapartida vale la pena cuando el uso de IA de un producto es lo bastante predecible y sostenido como para que sea más económico ser propietario de la infraestructura con el tiempo, cuando el producto necesita modelos ajustados a una tarea acotada y específica en lugar de uno de propósito general, o cuando mantener las solicitudes y los datos dentro de infraestructura propia es un requisito y no una preferencia. Es una contrapartida menos favorable para un uso de IA impredecible, con picos o todavía exploratorio, en cuyo caso la flexibilidad de una API medida supera el costo fijo de la infraestructura propia.

01

En profundidad

Un enrutador delante de modelos ajustados a un propósito específico

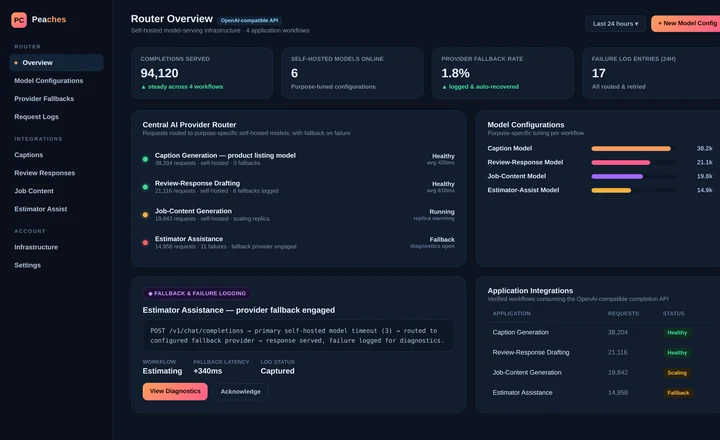
Peaches, construido en Omnitech, es una plataforma autoalojada de servicio de modelos: pone en marcha una API de completions compatible con OpenAI delante de modelos ajustados a un propósito específico, y luego enruta el tráfico de la aplicación —subtítulos, redacción de respuestas a reseñas, generación de contenido de empleos y asistencia para presupuestos— a través de un enrutador central de proveedores con respaldo (fallback) configurado y registro de fallas. Esa arquitectura es la forma concreta de este servicio: una capa de aplicación que llama a una única API interna y estable; una capa de enrutamiento que decide qué modelo atiende cada carga de trabajo; y una capa de operación responsable de mantener los modelos en funcionamiento.

02

En profundidad

Responsabilidad operativa, no solo infraestructura

Poner en marcha un modelo autoalojado es la parte sencilla; operarlo es el servicio real. Esto implica monitorear los propios modelos en cuanto a latencia y fallas, configurar un respaldo de proveedor para que un modelo autoalojado degradado o no disponible no derribe consigo una funcionalidad dependiente, y registrar las fallas con el detalle suficiente para diagnosticarlas en lugar de reintentar en silencio. El enrutador de Peaches hace exactamente esto: cada uno de sus cuatro flujos de trabajo de aplicación se monitorea de forma independiente, con el respaldo y el registro de fallas incorporados desde el diseño de la capa de enrutamiento y no agregados después como un añadido.
Encaje

A quién ayuda esto

  • Productos con un uso de IA predecible y sostenido, donde la infraestructura propia resulta más económica que los créditos medidos a lo largo del tiempo.
  • Equipos que necesitan modelos ajustados a una tarea acotada y específica, en lugar de un asistente de propósito general.
  • Empresas para las que mantener las solicitudes y los datos en infraestructura propia es un requisito, no una preferencia.
  • Equipos que ya cuentan con una integración de IA medida y quieren saber, con honestidad, si el autoalojamiento les convendría.

Alcance

Qué incluye

  • Aprovisionamiento de infraestructura en AWS u otra infraestructura dedicada
  • Selección de modelos y ajuste específico por carga de trabajo
  • Capa central de enrutamiento que expone una única API estable y compatible con OpenAI al código de la aplicación
  • Configuración de respaldo de proveedor y registro de fallas
  • Responsabilidad operativa continua sobre los modelos en funcionamiento

Entregables

Qué obtiene

  1. Infraestructura autoalojada de servicio de modelos
  2. API de completado compatible con OpenAI
  3. Enrutador central de proveedores de IA
  4. Controles de respaldo y registro de fallos

Evidencia

Trabajo relacionado

Mangoes ilustración del proyecto

Mangoes

Servicio LLM autoalojado y compatible con OpenAI para subtítulos de producción, respuestas a reseñas, contenido de trabajos y flujos de estimación.

Lecturas adicionales

Artículos técnicos relacionados

Operación de IA Autoalojada →

Related services

Related services

Consultoría de Inteligencia Artificial Privada →

Un punto de partida claro

Comience con una colaboración definida.

Elige el tipo de colaboración según tus objetivos. Todas las propuestas tienen un proceso claro, un alcance definido y condiciones comerciales acordadas antes de empezar.

  • Experiencia enfocadaCriterio técnico senior
  • Proceso claroAlcance acordado antes de empezar
  • Sin sorpresasCondiciones transparentes

Mostrando 01 de 01

Se muestran todas las propuestas.

Preguntas y respuestas

Preguntas sobre IA autoalojada

More questions? Feel free to reach out.

Explorar todos los servicios →
¿El autoalojamiento de modelos de IA elimina los costos de infraestructura?

No: el autoalojamiento convierte una factura de terceros medida por token en cómputo, almacenamiento y responsabilidad operativa propios. Es una contrapartida de costos, no una eliminación de costos, y vale la pena solo cuando el uso es lo bastante predecible y sostenido, o lo bastante acotado y específico, como para que ser propietario de la infraestructura resulte más económico o sirva mejor al producto con el tiempo que una API medida de propósito general.

¿Qué significa 'ajustado a un propósito específico' en una implementación de IA autoalojada?

Significa un modelo configurado y enrutado para una carga de trabajo específica, en lugar de utilizarse como un asistente de propósito general. Peaches ejecuta configuraciones independientes, ajustadas a un propósito específico, para subtítulos, redacción de respuestas a reseñas, generación de contenido de empleos y asistencia para presupuestos, cada una servida a través del mismo enrutador central.

¿Qué responsabilidades operativas conlleva la IA autoalojada, más allá de ponerla en marcha?

Monitorear los modelos en cuanto a latencia y fallas, configurar un respaldo de proveedor para que un modelo autoalojado degradado no derribe consigo una funcionalidad dependiente, y registrar las fallas con el detalle suficiente para diagnosticarlas. En Peaches, cada flujo de trabajo de aplicación se monitorea de forma independiente, con el respaldo y el registro de fallas incorporados en la capa de enrutamiento.

¿Cuándo es el autoalojamiento de IA la decisión equivocada?

Cuando el uso es impredecible, presenta picos o todavía es exploratorio. La flexibilidad de una API de terceros medida supera al costo fijo y a la responsabilidad operativa de la infraestructura propia, hasta que el uso sea lo bastante constante, o lo bastante específico para una tarea acotada, como para justificar poner en marcha y operar infraestructura dedicada.

Let's build what's next

Have a complex system that needs to be built right?

Whether you are starting from an idea, replacing an existing platform, or scaling a system, let's talk.

Better Technology.
Brighter Possibilities.