Poner en marcha un modelo autoalojado es una tarea de una sola vez. Operarlo en producción, con tráfico real de la aplicación, es una tarea continua, y es precisamente en esa disciplina operativa donde realmente vive Peaches, una plataforma de LLM autoalojada construida en Omnitech.
01Cómo leer este trabajo
Una API, varios modelos ajustados a un propósito específico
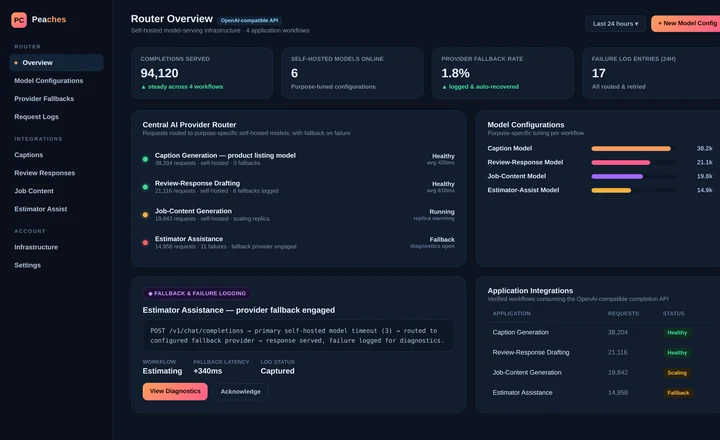
Peaches expone una única API de completions compatible con OpenAI al código de la aplicación —la misma forma de interfaz documentada en la referencia pública de la API de OpenAI (citada más abajo)— y enruta cada solicitud hacia uno de varios modelos ajustados a un propósito específico detrás de ella, según la carga de trabajo: subtítulos, redacción de respuestas a reseñas, generación de contenido de empleos y asistencia para presupuestos. El código de la aplicación nunca necesita saber qué modelo, ni cuántos, lo están atendiendo en realidad; esa decisión pertenece por completo al enrutador.
02Cómo leer este trabajo
El respaldo (fallback) es una decisión de enrutamiento, no un manejador de errores agregado después
Cuando un modelo autoalojado agota su tiempo de espera o se degrada, el enrutador puede hacer fallar la solicitud hacia afuera, o puede recurrir a un proveedor alternativo configurado y seguir atendiendo el flujo de trabajo mientras registra la falla para su diagnóstico. Peaches está construido en torno a la segunda opción: el respaldo forma parte del comportamiento diseñado del enrutador para cada flujo de trabajo que atiende, y no es una ruta de excepción agregada después de una interrupción.
03Cómo leer este trabajo
Registrar las fallas en lugar de ocultarlas
Un reintento silencioso oculta el hecho mismo de que un modelo se degradó. Peaches registra cada evento de respaldo con el detalle suficiente —qué flujo de trabajo, qué modelo, qué devolvió el intento principal— para diagnosticar fallas recurrentes en lugar de simplemente absorberlas. Ese registro es lo que convierte un "ayer la funcionalidad de IA se sintió lenta" en un incidente concreto y específico que puede investigarse.
04Cómo leer este trabajo
Qué requiere realmente atención continua
La carga operativa de la IA autoalojada consiste en monitorear la latencia y las fallas por carga de trabajo, mantener los proveedores de respaldo correctamente configurados a medida que cambian los patrones de uso, y revisar el registro de fallas en busca de patrones en lugar de tratar cada respaldo como un evento aislado. Nada de esto es exótico: es la misma disciplina operativa que necesita cualquier servicio en producción, pero es fácil subestimar su alcance cuando una implementación de modelo autoalojado se planifica solo hasta "poner en marcha el modelo".