セルフホスト型モデルを立ち上げること自体は一度きりのタスクです。しかし、実際のアプリケーショントラフィックに対して本番環境で運用し続けることは継続的なタスクであり、Omnitechで構築されたセルフホスト型LLMプラットフォームであるPeachesは、まさにその運用の規律の中に存在しています。
01実績の読み方
1つのAPI、複数の用途別チューニング済みモデル
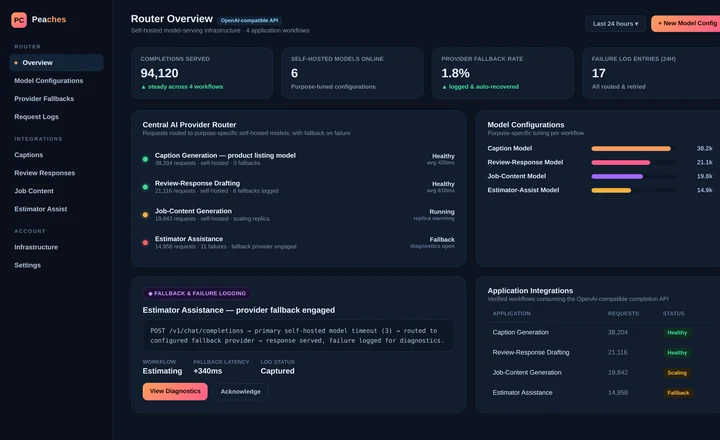
Peachesは、アプリケーションコードに対して単一のOpenAI互換のコンプリーションAPIを公開しています——これは公開されているOpenAI APIリファレンス(下記に引用)に記載されているのと同じインターフェース形状です——そして、ワークロードに応じて、キャプション生成、レビュー返信の下書き作成、求人コンテンツ生成、見積もり支援といった、その背後にある複数の用途別チューニング済みモデルのいずれかに各リクエストをルーティングします。アプリケーションコード側は、実際にどのモデルが、いくつ処理しているかを知る必要は一切なく、その判断はすべてルーターに委ねられています。
02実績の読み方
フォールバックは後付けのエラーハンドラーではなく、ルーティング上の判断である
セルフホスト型モデルがタイムアウトしたり性能が低下したりした場合、ルーターはリクエストをそのまま失敗させることもできますし、設定済みの代替プロバイダーにフォールバックし、診断のために障害をログに記録しながらワークフローを提供し続けることもできます。Peachesは後者の選択肢を軸に構築されています。フォールバックは、障害発生後に追加された例外的な経路ではなく、ルーターが提供するすべてのワークフローに組み込まれた設計上の動作の一部です。
03実績の読み方
障害を隠すのではなく記録する
黙って行われるリトライは、モデルの性能が低下したという事実そのものを覆い隠してしまいます。Peachesは、各フォールバックイベントを、どのワークフローで、どのモデルで、最初の試行が何を返したかがわかる十分な詳細情報とともに記録し、単に障害を吸収するのではなく、繰り返し発生する障害を診断できるようにします。このログがあることで、「昨日はAI機能の反応が遅かった気がする」という曖昧な印象が、調査可能な具体的なインシデントへと変わります。
04実績の読み方
実際に継続的な注意が必要なこと
セルフホスト型AIの運用負荷とは、ワークロードごとにレイテンシと障害を監視すること、利用パターンの変化に応じてフォールバックプロバイダーを正しく設定し続けること、そして各フォールバックを個別の出来事として扱うのではなく、障害ログをパターンとして継続的に見直すことです。これらはどれも特別な技術ではなく、あらゆる本番サービスに必要な運用上の規律と同じものです。しかし、セルフホスト型モデルの導入計画が「モデルを立ち上げる」ところまでしか想定していないと、この部分は過小評価されがちです。