

La sfida
Mantenere i flussi IA condivisi sotto controllo operativo.
Fornire una generazione IA riutilizzabile su più flussi di prodotto, mantenendo il servizio del modello principale sotto controllo operativo.
IA e infrastruttura
Caso di studio su un'architettura IA self-hosted che comprende un'API di completamento compatibile, l'instradamento dei modelli basato sul carico di lavoro e il fallback dei provider configurato.
Panoramica del progetto
Peaches è un servizio LLM self-hosted, compatibile con OpenAI, integrato nei flussi di produzione per didascalie, risposte alle recensioni, contenuti per gli annunci di lavoro e preventivazione. Le applicazioni possono selezionare modelli dedicati a uno scopo specifico e utilizzare un comportamento di fallback controllato, se configurato.
La sfida
Fornire una generazione IA riutilizzabile su più flussi di prodotto, mantenendo il servizio del modello principale sotto controllo operativo.
Approccio tecnico
Un'interfaccia di completamento compatibile centralizza l'instradamento verso i provider e seleziona i modelli in base al caso d'uso. Pulse considera Peaches come il proprio servizio IA principale e può utilizzare un fallback esterno configurato per i flussi in cui è richiesta continuità.
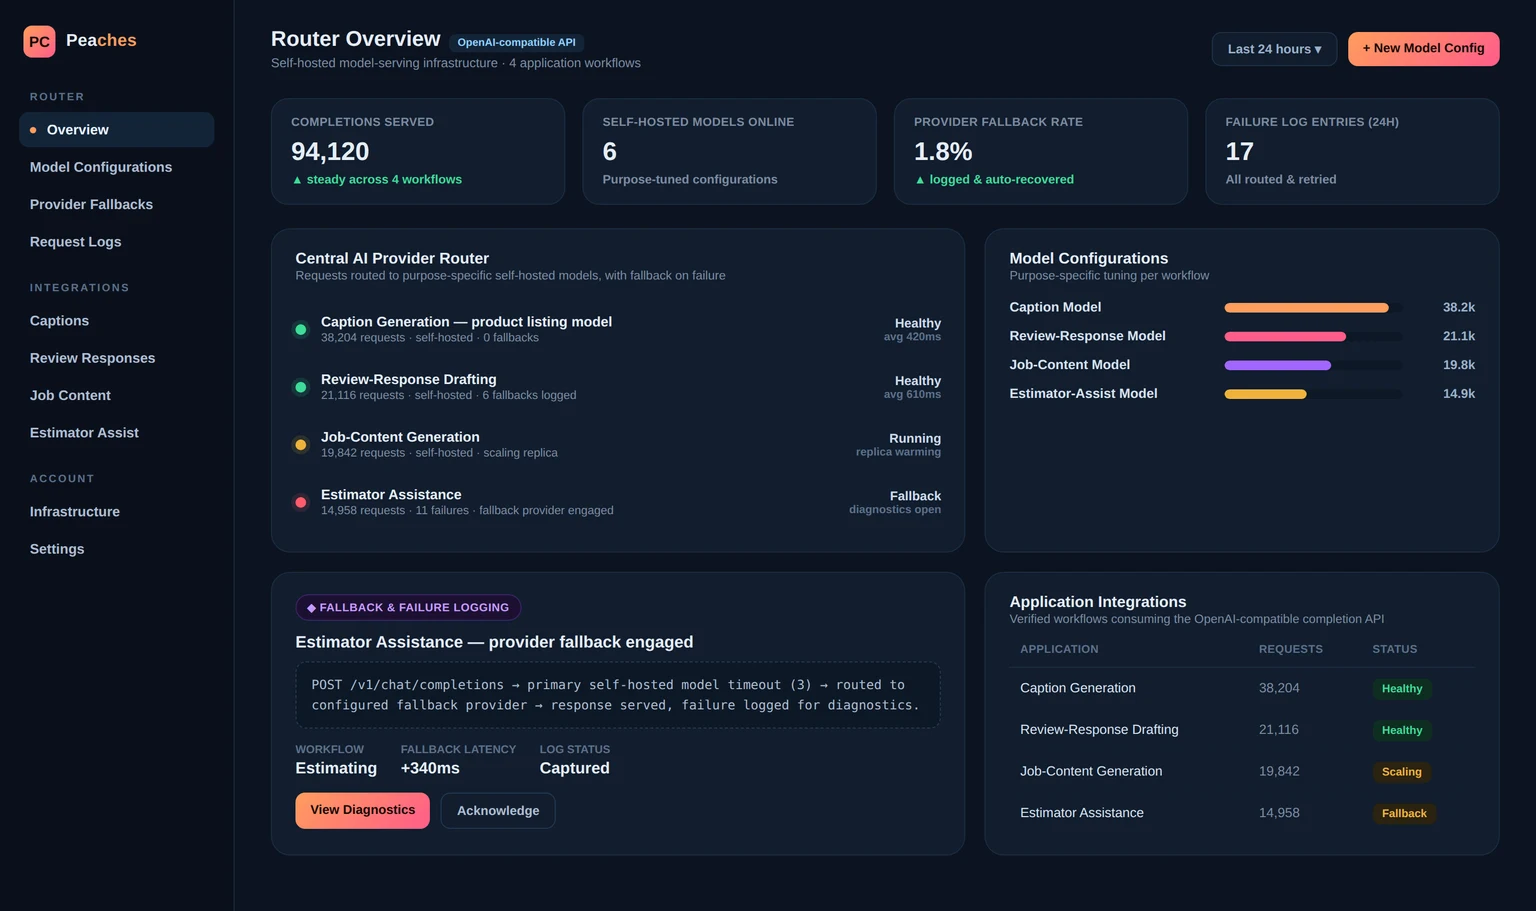
Router centrale dei provider IA — visualizzazione concettuale
Dashboard illustrativa costruita a partire dalle funzionalità documentate di Peaches: configurazioni di modelli self-hosted dedicate a uno scopo specifico, un'API di completamento compatibile con OpenAI e la registrazione di fallback/errori sui quattro flussi applicativi verificati. Non è una schermata del servizio reale.
Prodotti e interfacce
Ampiezza della piattaforma
Evidenze
Contesto aziendale
Didascalie, risposte alle recensioni, contenuti per gli annunci di lavoro e preventivazione condividono un'unica interfaccia di erogazione dei modelli, invece di avere ciascuno una propria logica di provider separata. Il fallback configurato offre ai flussi selezionati un percorso alternativo quando è richiesta continuità. Il self-hosting comporta inoltre responsabilità infrastrutturali e operative.
Il portfolio documenta quattro flussi applicativi e un'interfaccia di erogazione compatibile. Non vengono qui dichiarati risultati misurati in modo indipendente relativi a risparmi sui costi, accuratezza, uptime o tempi di risposta. Le immagini concettuali illustrano il sistema documentato e non costituiscono misurazioni di produzione.
Prima di impegnarsi in un'infrastruttura IA privata, è opportuno valutare l'idoneità del carico di lavoro, il comportamento in caso di errore, i confini dei dati e il costo operativo complessivo, oltre alla qualità del modello.
Hai un problema simile?
Per team che pianificano una funzionalità AI, un agente o un modello privato e hanno bisogno di evidenze prima di impegnare budget.
Richiedi un assessmentEsplori l'approccio
Domande e risposte
More questions? Feel free to reach out.
Discuta un progetto correlato →Peaches è un servizio LLM self-hosted, compatibile con OpenAI, integrato nei flussi di produzione per didascalie, risposte alle recensioni, contenuti per gli annunci di lavoro e preventivazione. Le applicazioni possono selezionare modelli dedicati a uno scopo specifico e utilizzare un comportamento di fallback controllato, se configurato.
Il lavoro include Infrastruttura self-hosted per l'erogazione dei modelli, API di completamento compatibile con OpenAI, Router centrale dei provider IA, Configurazioni dei modelli dedicate a uno scopo specifico, Integrazioni applicative e diagnostica, Controlli di fallback e di registrazione degli errori.
Muhammad Muzammil Qureshi ha operato come Direttore Tecnologico, con responsabilità su direzione tecnologica, architettura, delivery e sistemi operativi descritti in questo caso studio.
Peaches utilizza LLM self-hosted · Modelli ottimizzati per finalità specifiche.
Let's build what's next
Che parta da un'idea, debba sostituire una piattaforma esistente o far crescere un sistema, parliamone.
Better Technology.
Brighter Possibilities.