Attivare un modello self-hosted è un'attività una tantum. Gestirlo operativamente in produzione, per traffico applicativo reale, è un'attività continuativa — ed è proprio in questa disciplina operativa che risiede Peaches, una piattaforma LLM self-hosted sviluppata presso Omnitech.
01Come leggere il lavoro
Un'unica API, diversi modelli ottimizzati per uno scopo specifico
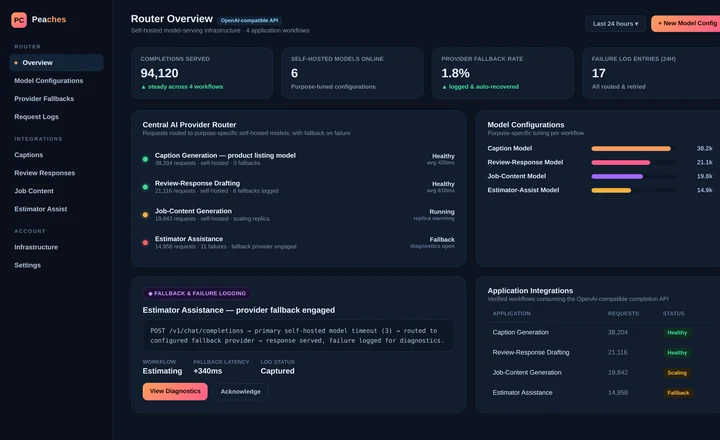
Peaches espone al codice applicativo un'unica API di completion compatibile con OpenAI — la stessa forma di interfaccia documentata nel riferimento pubblico delle API OpenAI (citato di seguito) — e instrada ciascuna richiesta verso uno dei diversi modelli ottimizzati per uno scopo specifico che si trovano dietro di essa, a seconda del carico di lavoro: didascalie, redazione di risposte alle recensioni, generazione di contenuti per annunci di lavoro e assistenza nella stima dei preventivi. Il codice applicativo non deve mai sapere quale modello, o quanti, lo stiano effettivamente servendo; quella decisione appartiene interamente al router.
02Come leggere il lavoro
Il fallback è una decisione di routing, non un gestore di errori aggiunto in un secondo momento
Quando un modello self-hosted va in timeout o si degrada, il router può far fallire la richiesta verso l'esterno, oppure può ricorrere a un provider alternativo configurato e continuare a servire il workflow registrando il fallimento a scopo diagnostico. Peaches è costruito attorno alla seconda opzione: il fallback fa parte del comportamento progettato del router per ogni workflow che serve, non un percorso eccezionale aggiunto dopo un'interruzione.
03Come leggere il lavoro
Registrare i fallimenti anziché nasconderli
Un retry silenzioso nasconde il fatto stesso che un modello si sia degradato. Peaches registra ogni evento di fallback con dettagli sufficienti — quale workflow, quale modello, cosa ha restituito il tentativo primario — per diagnosticare i fallimenti ricorrenti anziché limitarsi ad assorbirli. È questo log che trasforma "ieri la funzionalità IA sembrava lenta" in un incidente reale e specifico che può essere indagato.
04Come leggere il lavoro
Cosa richiede realmente un'attenzione continuativa
Il carico operativo dell'IA self-hosted consiste nel monitorare latenza e fallimenti per ciascun carico di lavoro, nel mantenere correttamente configurati i provider di fallback al variare dei pattern di utilizzo, e nell'esaminare il log dei fallimenti alla ricerca di pattern anziché trattare ogni fallback come un evento isolato. Nulla di tutto ciò è esotico — è la stessa disciplina operativa richiesta da qualsiasi servizio in produzione — ma è facile sottodimensionarlo quando un deployment di modello self-hosted viene pianificato solo fino ad "attivare il modello".